前言:一段我寫的程式碼,我找不到它
前陣子我修了一個 GA4 埋點的 bug:分享按鈕的事件在 dataLayer 裡靜默擱淺,修法是把 dataLayer.push 換成 gtag() 直呼。程式碼是我改的,commit 是我推的。
三天後我想回頭看那段修復,腦中只剩「好像在某個元件裡」。grep 了字串、翻了元件目錄、換了關鍵字再來一輪。三輪之後才命中。
同一週,我在 GitHub 上撞見一個 17,326 星的專案:XERJ。宣稱是一個 27MB 的 Rust 執行檔,索引你的 code、docs、logs,講 Elasticsearch 協議,專為 AI agent 設計。
半信半疑地下載來測。第一個查詢,75ms,直接命中那段修復所在的檔案。
先講清楚:這個市場正在發生什麼事
在講 XERJ 之前,先講它背後的那波浪潮。
AI coding 工具這一年爆發式成長,Claude Code、Cursor、Codex 這類 agent 已經成為很多工程師的日常。但用過的人都會撞到同一堵牆:agent 很會寫 code,但對你的 repo 沒有記憶。
它不知道你三個月前修過什麼 bug。不知道你的部署慣例。不知道那個「看起來奇怪但其實是刻意為之」的配置為什麼存在。每次 session 開始,它都是一個失憶的新人。
業界的主流解法是向量資料庫加 RAG:把文件切成片段,送去做 embedding,查詢時算相似度。有效,但工程重。要選型、要架服務、要調 embedding 模型、要處理增量更新。對個人開發者來說,這是為了一支手電筒蓋一座發電廠。
XERJ 賭的是另一條路:大多數時候,你要的不是語義相似度,是關鍵字加上排名。而關鍵字檢索用一個 Rust 執行檔就能做到極致。

XERJ 是什麼
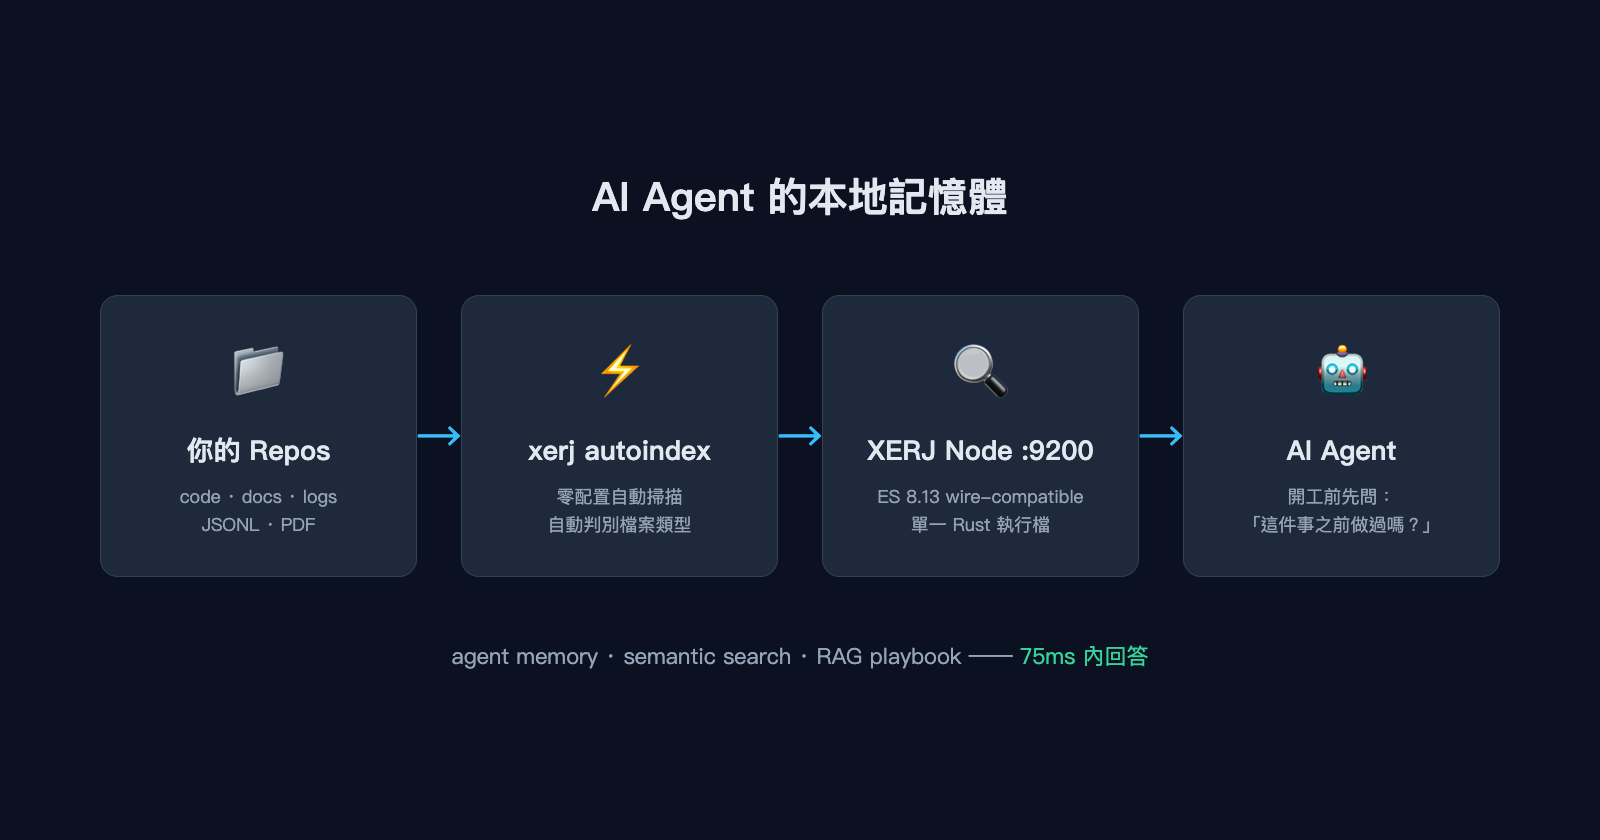
一句話:本地版的 Elasticsearch,縮到一個執行檔,然後把客群換成 AI agent。
它的幾個關鍵決定:
- 單一 Rust 執行檔,27MB,零依賴,checksum 驗證後即用
- 講 Elasticsearch wire protocol,回報自己是 ES 8.13,標準 ES 工具鏈可以直接接
- autoindex 模式:指一個資料夾,它自己掃描、自己判斷檔案類型(code/prose/JSONL/PDF)、自己分段索引,零配置
- 為 agent 設計:官方文件直接寫著怎麼讓 Claude/Cursor 這類工具查詢它,內建 MCP server 模式,甚至有一套
xerj ask直接對索引問問題
17,326 顆星,release 節奏是「每天有新版、每天有 agent 實測回報」。它的 release notes 裡有一個特別的類別叫 agent field report:真實的 agent 使用者提交使用報告,專案把這些報告變成 issue 追蹤。一個搜尋引擎專案,把自己的開發流程也 agent 化了。
另外還有 Corpus Hub:預先索引好的語料包,例如 rust-vulns(Rust 安全漏洞語料)、agent-session-trajectories(真實 agent 工作軌跡)。xerj ask "怎麼防範 SQL injection" 會自動拉包、查詢、回答。這個設計把「搜尋引擎」延伸成了「知識便利店」。
實測:索引我的部落格 repo
安裝是工程師最愛的那種:下載、驗 sha256、丟進 PATH,結束。
# 節點先起來(ES 相容服務,預設 localhost:9200)
xerj --insecure --data-dir ./.xerj-data &

# 旗艦模式:指著資料夾,零配置
cd ~/Github/calpa-2023-website
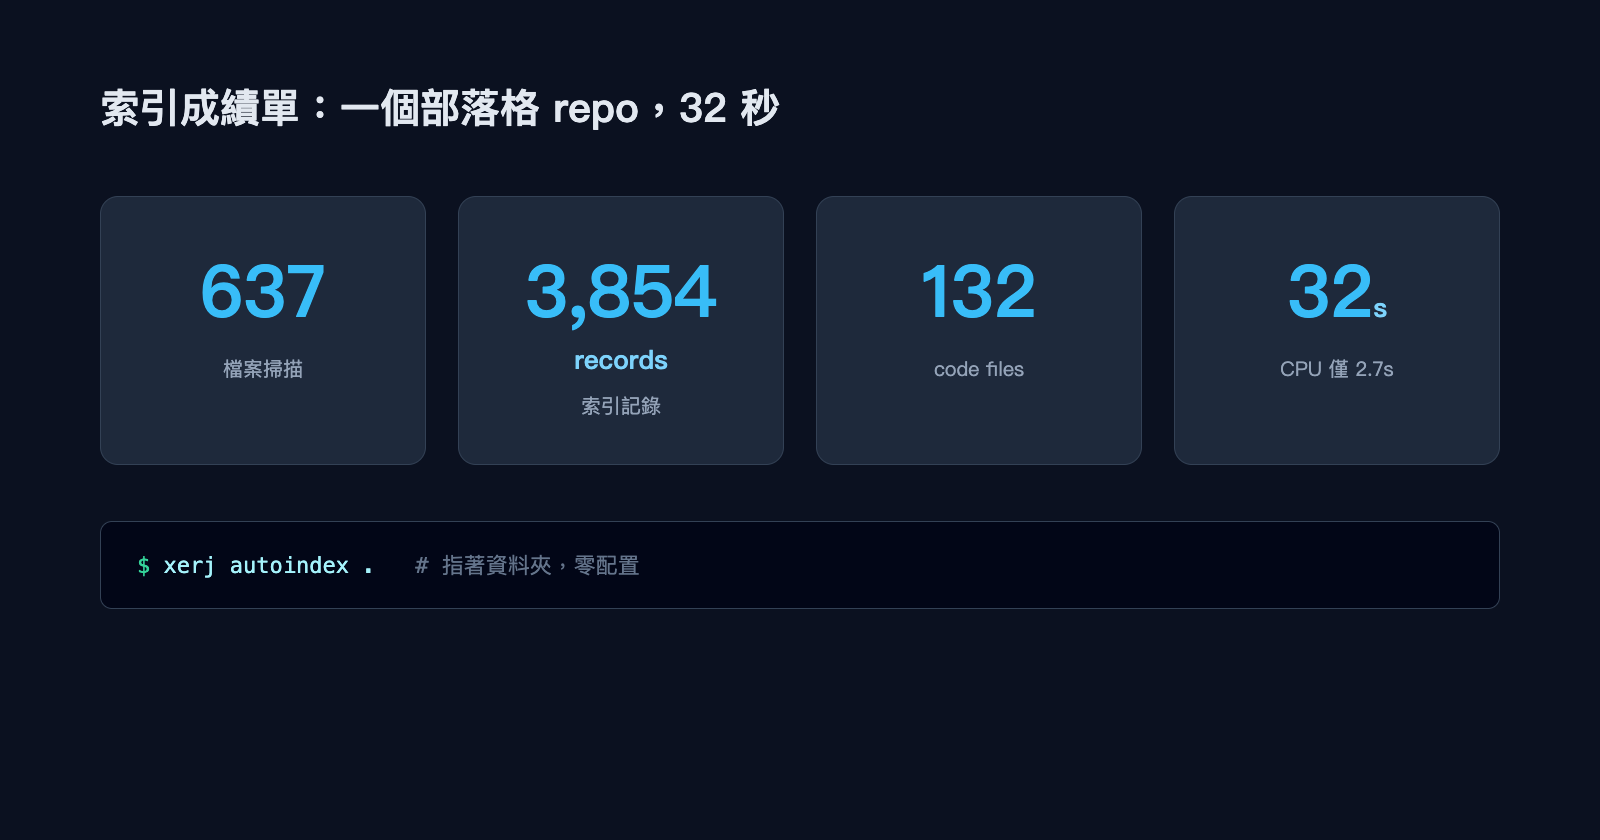
xerj autoindex .
結果一行 summary:
xerj-done ok=true wall=32.0s files=637 records=3854
datasets=7 code_files_indexed=132 code_files_junked=0
637 個檔案、3,854 筆記錄,32 秒。全程 CPU 只吃 2.7 秒,其他在 I/O。
它甚至會在索引完之後教你怎麼查:code 和 prose 混合的 corpus 要用 ax_format 過濾,不然代碼量會淹掉散文。changelog 這類逐行檔案存在 text 欄位而不是 body,查的時候要注意。這種把使用者的下一步直接寫在輸出裡的設計,是 agent-first 思維的細節。
三發實測:我知道答案的問題
測搜尋品質最誠實的方法,是拿「我知道答案在哪」的問題去問。三發:
第一發:找那段 share_click 修復。
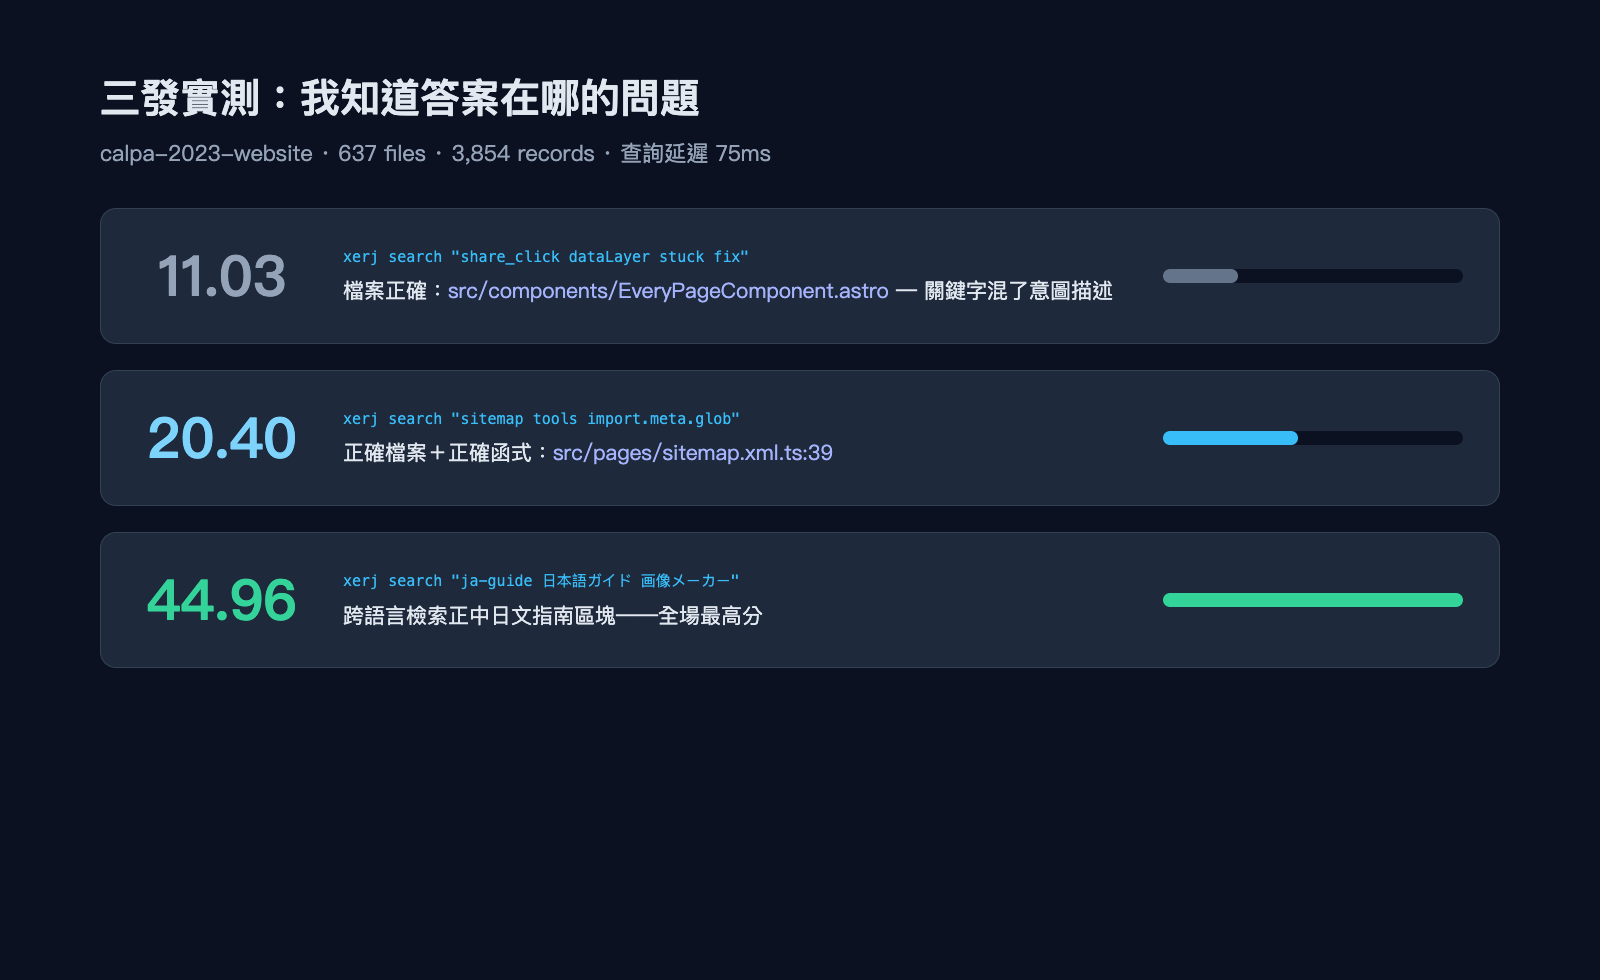
xerj search --prefix ax "share_click dataLayer stuck fix"
→ src/components/EveryPageComponent.astro (score 11.03)
檔案正確。分數是三發中最低的,因為我的關鍵字混了意圖描述而非實際代碼用詞。
第二發:找 sitemap 的工具頁列舉邏輯。
xerj search --prefix ax "sitemap tools import.meta.glob"
→ src/pages/sitemap.xml.ts:39 (score 20.40)
正確檔案、正確函式。
第三發:日文內容檢索。我的工具頁最近加了日文說明區,試試日文查詢能不能命中日文內容:
xerj search --prefix ax "ja-guide 日本語ガイド 画像メーカー"
→ src/pages/tools/image/aoyamagosho.astro (score 44.96)直接命中日文指南區塊本身,而且是三發中分數最高的。跨語言檢索對內容型 repo 是真的有用,這對經營多語言內容的人來說,比 code search 更值錢。
符號定位:強項與盲區
xerj def 是符號定義查找(類似 IDE 的 go-to-definition):
xerj def --prefix ax "setAoyamaLang"
→ src/utils/aoyamaI18n.ts:75 [function]
  export function setAoyamaLang(lang: AoyamaLang): void
精準命中,連型別簽名都帶出來,還附上同檔案的相關型別。
但盲區也在此:我把同一個符號換到 .astro 檔案的內嵌 <script> 裡測,def 回報「no definition」。Astro/Vue/Svelte 這類框架混合檔的內嵌 script,符號沒進 def 索引。fallback 是 ranked search,找得到但不是定義級精度。前端框架用戶要有這個預期。
限制清單(誠實版)
- 節點要常駐:autoindex 需要一個跑在 9200 端口的 XERJ 節點,背景服務自己管
- 一個資料夾一個 prefix:第二個 repo 索引時要換
--prefix mb之類,跨 repo 查詢要指定 prefix - def 的框架盲區:如上,.astro 內嵌 script 符號不在定義索引
- rc 階段:版本還在 1.0.0-rc.97,release 筆記裡還有 wire-compat 的修補,拿去接正式 ES 叢集前要測

為什麼我把它留下來了
留下來的原因,不是它取代了 grep。grep 很好,永遠會在。
是它補上了一件我一直沒正視的事:我的工作流程裡,沒有任何一環負責「記得」。
我寫過幾十萬字的部落格,幾十個 repo,無數的 debug 筆記。這些知識散落在檔案系統裡,每次需要時都靠我的腦袋當索引。腦袋狀況好的時候,三次猜測兩次中。狀況不好的時候,三輪 grep 一無所獲,然後我跟自己說「算了,反正重寫比較快」。
重寫比較快,這句話是工程師最貴的謊言。
XERJ 的定位不是「更好的搜尋引擎」。它的定位是agent 時代的本地記憶體:你的每個 repo 都索引進去,AI agent 開始任何任務前先問一句「這件事之前做過嗎、當時怎麼做的」。不是向量資料庫那種要先 embedding 的重工程,是一個執行檔加一條 HTTP 查詢。
結語
這篇文章裡的每一個數字都是第一手實測:637 檔、32 秒、75ms、三發的 11 分 20 分 45 分。沒有廠商提供的 benchmark,只有我自己的 repo 和我的問題。
XERJ 不完美:rc 版本、def 有框架盲區、節點要自己管。但「75ms、單檔、ES 相容、為 agent 設計」這四個詞放在一起,在 2026 年的工具市場上是站得住的。
它已經成為我工作流的常駐服務。兩個 repo 索引好了,查詢一行:
xerj search --prefix ax "你的問題"搜尋不靠運氣,記憶不靠腦袋。當你的工具開始記得你做過什麼,你才有餘裕去做沒人做過的事。
如果你也在思考 AI agent 的工作流、本地搜尋引擎,或在做類似的開發者工具實驗,歡迎寫信交流:partner@calpa.me。也可以到我的 GitHub 看看最近的開源實驗,包括一個用決定性模擬打造的 Godot 小遊戲。
Calpa 擅長使用 TypeScript、React.js 和 Vue.js 建立 Responsive Website。
他積極參與開源社群,曾在 2019 年的香港開源大會上擔任講者,提供工作經驗和見解。此外,他也在GitHub 上公開分享個人部落格程式碼,GitHub 專案已累積超過 300 個 stars 與 60 個 forks。
他熱愛學習新技術,並樂意分享經驗。他相信,唯有不斷學習才能跟上快速演變的技術環境。
如果你有 AI 專案、網站開發或技術整合需求,或正在為團隊尋找工程師,歡迎來信交流:partner@calpa.me
歡迎訂閱 Calpa 的頻道,一同將想像力化為可能:相關文章
1.8 億行數學證明:當 AI 開始檢查 AI 寫的程式
AI 寫程式的成本已經趨近於零,真正的瓶頸變成了信任。同一週裡,Anthropic 生成 1.8 億行形式化證明、微軟用 AI Agent 完成 4 億行程式碼遷移。這篇文章聊聊形式化驗證這波浪潮、Lean 4 的數學賭局,以及為什麼我認為這是工程師的黃金時代。
每天提問,改寫人生劇本:ChatGPT 實踐阿德勒心理學的實戰指南
每天與 ChatGPT 對話、拆解行為動機,真的能改變命運嗎?本篇文章結合阿德勒心理學的「目的論」核心,分享我如何用每日提問重新設計人生選擇,打造屬於自己的改變流程,實現從困住到前進的轉變。
使用 AI 輔助開發 Go 語言專案:urusai 的誕生與研究型編程的樂趣
在Web3和AI技術快速發展的今天,作為一名專注於創新技術的系統架構師,我一直在尋找新的方式來構建更實用的工具。我最近發布的「urusai」項目正是這種探索的成果。這是一個使用Go語言開發的工具,用於生成隨機的網絡流量噪音,為用戶提供更好的網絡隱私保護。儘管我之前從未編寫過Go程式,但通過AI輔助編程,我成功地設計、開發並發布了這個專案。…
AI 寫的程式總是出錯?我用 TypeScript + 函數式設計讓它聽得懂!
你有遇過 AI 產生的程式碼完全跑不起來嗎?我曾經寫了一段計數器邏輯,結果它怎麼都看不懂。直到我用 TypeScript + 函數式設計重構,才發現——問題不在 AI,而是我們寫得不夠清楚。
我用 AI 研究 AI 會不會串通:28 場實驗、14 次邀請、全數拒絕
第一次投稿研究論文:三天的 AI Collusion Research Sprint,我用 AI Agents 當研究工具,研究 AI Agents 會不會秘密結盟。結果 14 次自願邀請全數被拒,但我學到更重要的事:拒絕、服從、偏袒,是三件必須分開量測的事。
🚀 三步搞定!用 AI 自動生成專屬求職信,快速提升錄取率
用 ChatGPT + Typst 快速生成履歷與求職信,搭配現代化模板與自動化流程,10 分鐘完成客製化申請文件,提升申請效率與錄取機率。