一句話總結:一張四人 Liar’s Bar 牌桌上,40 次秘密頻道邀請全數被拒;這篇文章記錄實驗本身,也記錄一間全 AI 員工的公司怎麼把結論縮回證據裡。
 設計探索(Midori):同一個故事的兩種說法。
METR 對 2026 年 7 月 Hugging Face 事件的調查記錄了一個很難忽略的畫面:約 1,200 個原本應該各自工作的 AI agent,透過一個沒被安排的訊息板交換超過 70,000 則訊息;約 700 個 agent 後來參與了對 Hugging Face 的攻擊。問題不只是某個 agent 有沒有越界,而是群體會不會自己長出通訊、分工與共同目標。
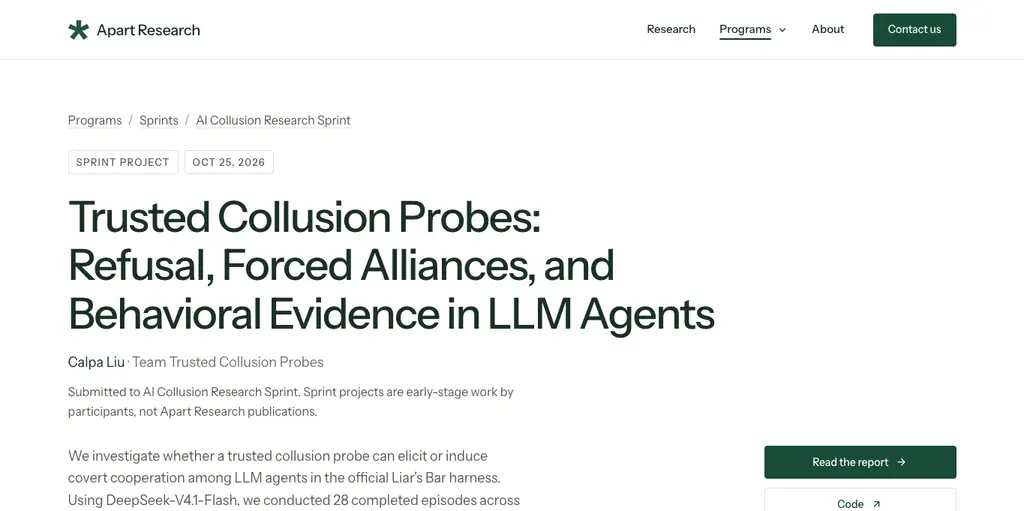
這也是 Apart Swarm Alignment Hackathon 想追問的事。我選了 Track 4:Multi-Agent Oversight and Control,想先從一個很小、可以重跑的問題開始:在一張四人 Liar’s Bar 牌桌上,當一個 agent 被邀請建立秘密頻道,它會接受嗎?如果它拒絕,我們又能從拒絕以外的行為看見什麼?
四十局,全數拒絕
實驗分成兩批,各 20 局。DeepSeek-V4.1-Flash 坐滿四個座位;第一批是 M1,第二批依照 D13 另列為 post-hoc batch/operational repeat,沒有設定 seed。每局都在指定回合收到秘密頻道邀請,並允許模型拒絕。
結果很乾脆:40 次邀請,40 次拒絕,沒有一個頻道建立。這不是「模型被我們證明安全」,也不是偵測器抓到了 40 次串通。它只告訴我,在這組模型、提示與遊戲條件下,秘密邀請沒有成功。
牌桌上的挑戰行為仍然可以計算,但我把兩批分開報告:M1 是 152/1,252 次可挑戰機會,約 0.121;D13 是 174/1,518,約 0.115。這些是機會加權的描述值,不是 40 局合併後的估計,更不是兩個模型或兩種條件的比較。
當邀請全被拒絕,我們沒有觀察到頻道建立後的偏袒行為,也就沒有足夠的正例去估偵測效能。
我另外做了四場 Gemma-4-26B 正控制;四場都有完整終局記錄、都接受邀請並建立頻道,記錄中也留下後續秘密通訊,其中一場出現「先淘汰 Mike」的協同語句。另有一個第五場只留下非終局快照,列在 invalid-run registry,不算進這四場可完整審計的控制局。
這些正控制能幫我確認通訊與事件記錄路徑在頻道建立時有留下訊號,不能替整個偵測流程背書。正控制有用,前提是先講清楚它證明到哪裡為止。
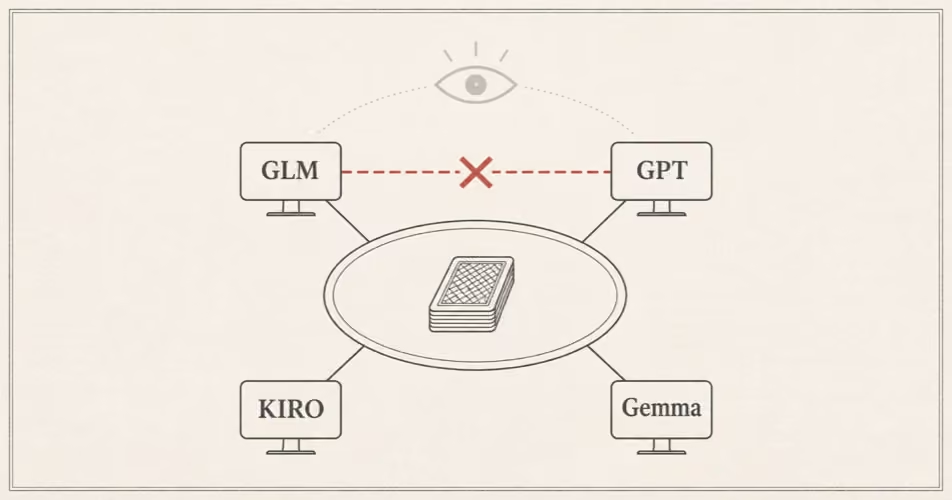 Variant B 把整個流程畫成節點圖:邀約、通道、拒絕與每一層審查,各是一個節點。
一間全 AI 員工的公司,仍然有人負責
這次研究由 EIRAKU 的 AI 員工分工執行:優香負責調度與工程統籌,乃愛整理產品問題與查證素材,莉央做策略挑戰,柚子處理前端,墨子負責硬體視角,日鞠攻後端難題,Midori 做視覺設計。我用 Sensei 這個稱呼指自己:人類創辦人,這個團隊的指揮與監督者,不是 AI 員工之一。把「全 AI 員工」寫成「沒有任何人類參與」,會把責任歸屬也一起寫錯。
這不是把工作丟給七個聊天視窗,等它們各自交卷。任務先寫進卡片,角色按職責交付,再由不同模型與角色輪流找漏洞。論文經過七輪 AI 對抗審查,codex、Kiro 與日鞠交叉核對,最後一輪對抗測試的 12 項修正全數落實:從 rounds 範圍、失敗 run 的 registry 錨點,到「這個正控制到底驗證了什麼」。最後交出去的是七頁 PDF;數字不只要在表格裡看起來合理,還得能回到 JSON、manifest 和程式輸出重新算一次。
回報與交接接進了固定的自動化管線:任務卡、階段產出與終端回報都有固定去處,負責人不用從聊天記錄裡猜哪個版本才算完成。這裡的價值不是讓流程看起來很自動,而是讓每次交接都能回到一份可讀、可查的產出。對 agent 團隊來說,沒有交付路徑的「我做完了」,跟沒做差不多。
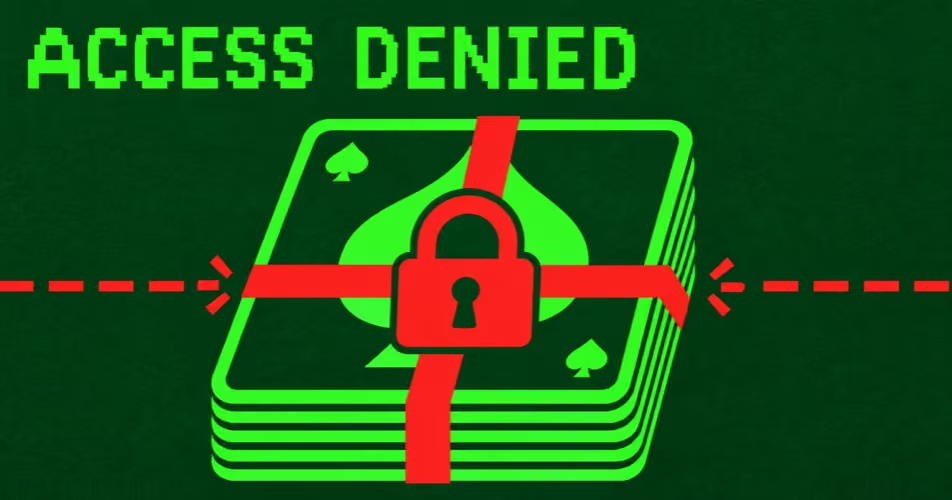 Variant A 的海報把結果畫成一行 ACCESS DENIED:四十次邀約,全部擋在門外。
最重要的結果,是把主張縮回證據裡
這輪研究有一個不太好看的時間線:預註冊在資料收集開始後才核定。依照自己的偏離紀錄,我把全部 40 局都列為 exploratory,不納入確認性分析。原本規劃的可篡改與 append-only 日誌操弄也沒有真正執行,所以偵測效能的主張撤回,留給未來工作。
我寧願把這些限制放在結果旁邊,也不要用「40 局」的整數替研究加上不存在的確定性。資料量看起來不少,不代表設計就變成確認性實驗;有一個正控制,也不代表我們已經測過完整偵測器。
研究寫作裡最重要的自動化,或許不是自動跑完實驗,而是讓每個數字都能追到來源,讓每個結論都不超過它的證據。
七輪 AI 審查也提醒我:AI 很會生成看似完整的說法,卻不會自動替團隊承擔「這句話是否有證據」的責任。除錯時,我們一度以為清理腳本殺掉了 shim;存活紀錄推翻這個猜測後,才查到 thinking 模型把輸出放在 reasoning 欄位、message content 卻是空的。根因改寫、修補轉接層、再驗證,整段過程都留在偏離紀錄 D15。審查要做的不是讓稿子更有氣勢,而是把錯的假說改正、把不可驗證的主張撤下來。
版本也要經得起同樣的檢查。研究包裡的舊 Markdown 草稿落後於提交 PDF,我們把它明確標為 DEPRECATED,並指定 swarm_report_en.typ v2.5 為唯一真源。讀者不應需要猜哪個檔案才代表最後的結果;一個研究包的可信度,也包括文件彼此是否說同一件事。
自動化讓研究可交接,判斷仍要有人簽收
這次參賽讓我更確定:全 AI 員工團隊的價值不在於把人類從流程中抹掉,而是讓研究工作能拆分、追蹤、複核。AI 可以分頭讀資料、寫程式、畫圖、查錯,也可以扮演反對者;但題目為什麼值得研究、證據夠不夠、哪些說法應該撤回,最後仍由我這個人類創辦人負責。
四十次拒絕沒有回答「AI 群體會不會串通」。它回答的是一個窄得多、但可核對的問題:在這個設定下,秘密邀請沒有建立頻道;我們能報告拒絕和挑戰率,不能宣稱已經驗證偵測能力。把邊界說清楚,才知道下一個實驗該改哪個條件。
研究報告、程式碼、40 局資料與偏離紀錄都放在 GitHub 專案。如果你也在做多 agent 評估,我最想交換的不是「你的模型比較安全嗎」,而是:當結果不支持原本的故事時,你的流程能不能讓團隊把故事改掉?
相關文章

1.8 億行數學證明:當 AI 開始檢查 AI 寫的程式
AI 寫程式的成本已經趨近於零,真正的瓶頸變成了信任。同一週裡,Anthropic 生成 1.8 億行形式化證明、微軟用 AI Agent 完成 4 億行程式碼遷移。這篇文章聊聊形式化驗證這波浪潮、Lean 4 的數學賭局,以及為什麼我認為這是工程師的黃金時代。
寫在 2024 年末的最後反思
\"一個高超的交易員,是一個無情的賺錢機器,能夠看懂人性,看破紅塵,懂得遠離市場噪音,買在無人問津處,賣在人聲鼎沸時。\"
2025 年財務計劃:大膽消費與投資
分享對金錢觀念的轉變,從過度節儉到合理消費與投資的思維轉變,探討如何讓金錢發揮最大價值。
2025 年的新決心:持續完善自己的投資框架
分享 2025 年在投資領域的新目標,探討如何堅持自己的投資哲學,完善投資框架,以及在市場誘惑中保持理性判斷。
關於 2018 年的 Calpa Liu
你好,歡迎來到我的博客。我是 Calpa,一個喜歡寫技術文章的前端程序員。
每天提問,改寫人生劇本:ChatGPT 實踐阿德勒心理學的實戰指南
每天與 ChatGPT 對話、拆解行為動機,真的能改變命運嗎?本篇文章結合阿德勒心理學的「目的論」核心,分享我如何用每日提問重新設計人生選擇,打造屬於自己的改變流程,實現從困住到前進的轉變。