給趕時間的你:本地跑 LLM 只看三件事,RAM 上限、記憶體頻寬、再來才是 FLOPS。同樣 128GB,Mac Studio M5 Max 大約 HK$35k,吞吐多數場景贏過 HK$54k 起跳的 NVIDIA DGX Spark;如果你的目標只是 20B 到 32B 模型,一台 HK$7k 的 Mac mini M6 就夠用。
最近我為了「要不要買一台本地 AI 機器」把 2026 年 11 月能找到的實測數據翻了一遍:NVIDIA DGX Spark、Apple M5/M6 全系列、MLX 社群排行榜、Reddit 與 Hacker News 的機主回報。這篇是調研結論,所有數字都標了查證時間與來源,方便你自己驗。
MLX 是什麼:蘋果把統一記憶體變成護城河
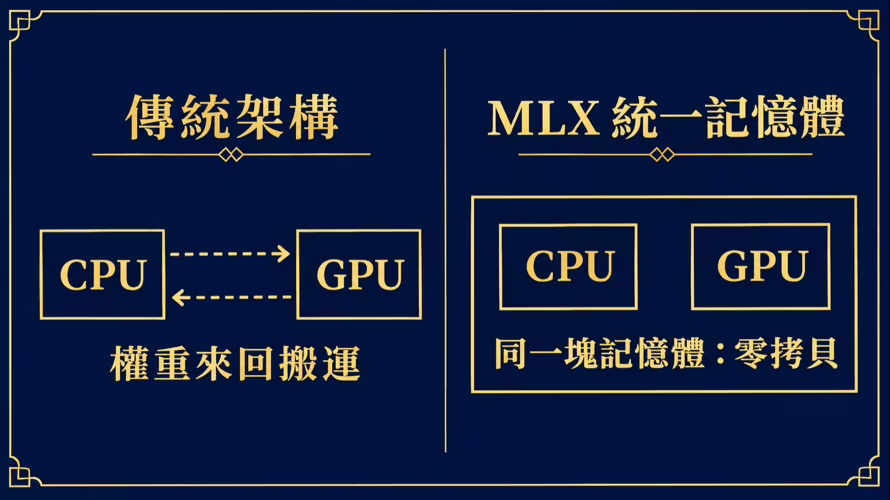
MLX 是 Apple 官方開源的陣列運算框架,專為 Apple Silicon 的統一記憶體架構設計。傳統做法裡模型權重要在 CPU 記憶體和 GPU 顯示記憶體之間來回搬,MLX 的做法是 tensor 只存一份,CPU 和 GPU 直接讀同一塊記憶體,零拷貝。生成文字時每輸出一個 token 都要把權重讀一遍,所以誰的記憶體頻寬高,誰的 tok/s 就高,這就是為什麼頻寬比 FLOPS 更值得看。
量化是內建能力,不是外掛。mlx_lm.convert 幾秒內把 Hugging Face 上的 checkpoint 轉成 4-bit,一個 7B 模型縮到原本三分之一左右,8GB 記憶體的筆電都能微調。生態端三件事讓它從玩具變產線:
- LM Studio 從 v0.3.4 起內建 MLX 引擎,v0.4.2 加上 continuous batching,在介面裡搜 Hugging Face 就能下載 MLX 模型,還附 OpenAI 相容的本地 server
- Ollama 已經把 Mac 上的後端轉向 MLX
- Hugging Face 上的 mlx-community 組織放了幾千個現成 4-bit 模型,連 Qwen 官方團隊都特別為 MLX 做了優化
想看實測排行,RapidMLX 的 benchmarks 頁是群眾版本的 llama-bench 榜:58 份提交、11 台 Apple 機器、35 個模型與晶片組合,2026-11-11 剛更新。
2026 年 11 月的 Apple 陣容:M6 mini 很香,但有一個陷阱
Apple 在 2026 年 8 月發表 M6 與 M5 Ultra,9 月 22 日開賣。M5 世代起每一顆 GPU core 都內建 Neural Accelerator,prompt 處理快 3.3 到 4 倍;但生成速度只提升約 15%,因為瓶頸在記憶體頻寬,而頻寬是買機器時就鎖死的。
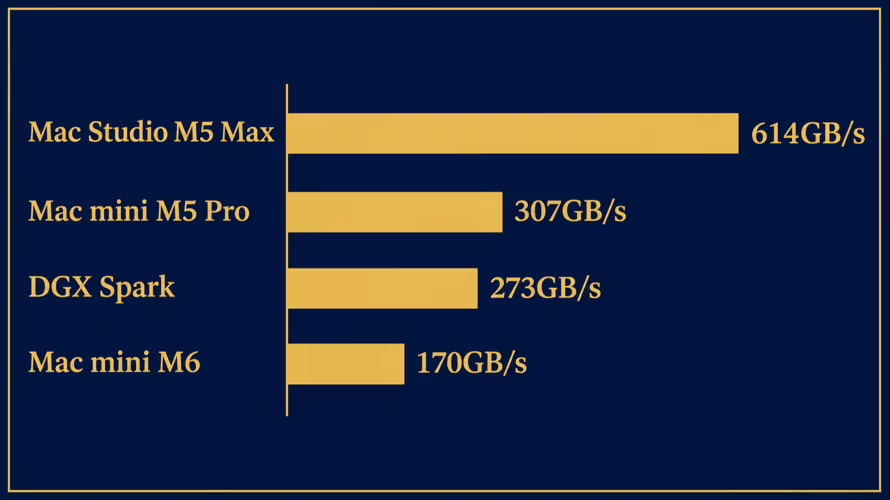
| 機器 | 美金定價 | 記憶體上限 | 頻寬 | 實測重點 |
|---|---|---|---|---|
| Mac mini M6 | $899 | 32GB | ~170GB/s | Qwen 9B 約 27 tok/s、GPT-OSS 20B 約 41 tok/s、Qwen 27B 級約 32 tok/s |
| Mac mini M5 Pro | $1,699 | 64GB | 307GB/s | 70B 模型 Q4 塞得下 |
| Mac Studio M5 Max | $2,499(128GB 加購約 +$2,000) | 128GB | 614GB/s | Qwen 32B Q4 約 40-50 tok/s、GPT-OSS 120B 約 14-19 tok/s、Llama 4 70B 約 25-32 tok/s |
| Mac Studio M5 Ultra | $5,499 | 最高 512GB | ~819GB/s | 120B 級旗艦首選 |
陷阱在第一行:M6 mini 的晶片名字最亮,記憶體卻封頂 32GB。實測影片裡它的長文生成約 32 tok/s,反而輸給同一個機殼的 M5 Pro(約 69 tok/s)。買本地 AI 機器,記憶體上限比晶片名字重要。
DGX Spark 的現實:一年漲 74%,頻寬只有 Mac 的一半
NVIDIA DGX Spark 主打 128GB 統一記憶體與一 petaflop 的 FP4 算力,聽起來正好對上本地 LLM 需求。三個實況:
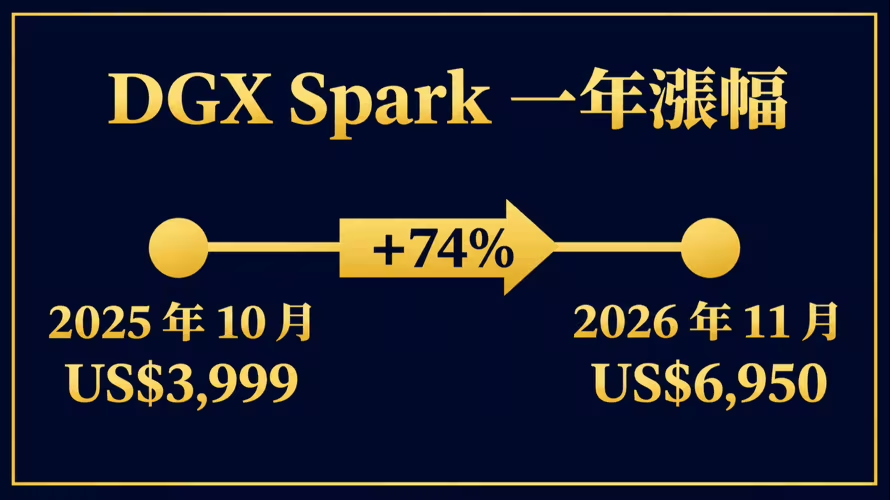
- 價格:128GB 版從 2025 年 10 月上市價 US$3,999 漲到 US$6,950,一年漲 74%,折港幣約 54k;香港水貨市場傳到 6 萬級。64GB 新版反而要 US$4,999
- 吞吐:GPT-OSS 120B 在 MXFP4 下約 41 到 59 tok/s(32k context 掉到 40 出頭);Qwen 27B 級 dense Q4 約 11.4 tok/s;Llama 70B Q4 只有 4 到 5 tok/s。同一份 GPT-OSS 20B 測試裡,一張 RTX 4090 跑出約 123 tok/s,是 Spark 的 2.3 倍
- 社群風向:NVFP4 加速半年未落地、CUDA 軟體相容性被抱怨、有人 Micro Center 花了 8 千美金還在問「是不是要買第二台才有用」
同 128GB 直接對照:誰的 CP 值高
| Mac Studio M5 Max(128GB) | DGX Spark(128GB) | |
|---|---|---|
| 價格 | 約 HK$35k(2026-11 查證) | 官價約 HK$54k,水貨 6 萬級 |
| 頻寬 | 614GB/s | 273GB/s |
| Qwen 32B 級 | 40-50 tok/s | ~11.4 tok/s |
| GPT-OSS 120B | 14-19 tok/s(Q4) | 41-59 tok/s(MXFP4 官方棧) |
| 生態 | MLX+LM Studio+Ollama | CUDA/MXFP4(承諾中) |
有趣的翻轉在 GPT-OSS 120B:Spark 靠 NVIDIA 官方 MXFP4 棧在這個模型上反超。這是它唯一的實質賣點,而且依賴 NVIDIA 持續餵優化。其餘大多數場景,Mac 這邊用更低的價錢拿到更高的 tok/s,還有 MLX 的量化與微調工具鏈。
三個預算檔位的建議
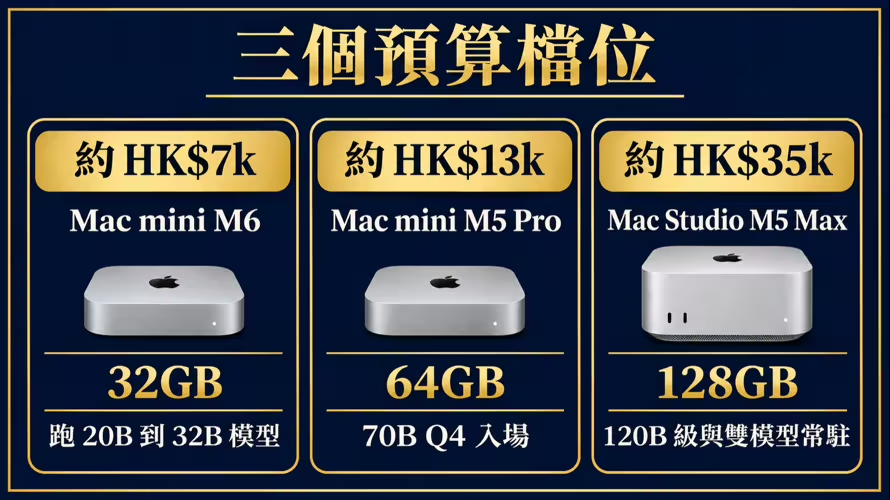
| 預算 | 買什麼 | 能跑什麼 |
|---|---|---|
| 約 HK$7k | Mac mini M6(32GB) | 20B 到 32B 模型流暢(27 到 41 tok/s),agent 與日常助理夠用 |
| 約 HK$13k | Mac mini M5 Pro(64GB) | 70B Q4 入場 |
| 約 HK$35k | Mac Studio M5 Max(128GB) | 120B 級與雙模型常駐,多數場景勝 Spark,僅 GPT-OSS 120B 落後 |
最後一個誠實的選項:不買
把硬體折舊攤到 token 上,雲端 API 幾乎永遠贏:Clarifai 上的 gpt-oss 120B 中位數輸出 313 tok/s,GLM 這類旗艦 API 每天用量折算更是零頭。本地機器的價值只在兩個硬需求:資料不能出門,或者要離線。沒有這兩個需求,把 35k 留著訂雲端額度,CP 值高上一個量級。
我自己的結論:這波先不買。等 Spark 的 NVFP4 真的落地、或者記憶體價格回檔,再重算一次這張表。
參考來源
- Apple Newsroom:M6 與 M5 Ultra 發表(2026-08):https://www.apple.com/newsroom/2026/08/apple-introduces-m6-and-m5-ultra-for-a-big-leap-in-performance-and-ai-compute
- Apple ML Research:MLX 與 M5 Neural Accelerators:https://machinelearning.apple.com/research/exploring-llms-mlx-m5;RDMA 分布式推理:https://machinelearning.apple.com/research/mlx-distributed-inference
- Apple Silicon tok/s 彙整:LLMCheck:https://llmcheck.net/blog/apple-silicon-m5-max-local-ai-guide;Presenc AI:https://presenc.ai/research/best-local-llms-for-mac-m5-2026
- DGX Spark 實測與機主回報:r/LocalLLaMA:https://www.reddit.com/r/LocalLLaMA/comments/1scf1x8/;r/LocalLLM:https://www.reddit.com/r/LocalLLM/comments/1xexjo7/
- Spark 128GB 漲價至 US$6,950(快科技,2026-11-02):https://news.mydrivers.com/blog/20261102.htm
- RapidMLX benchmarks(58 份提交,2026-11-11 更新):https://rapidmlx.com/benchmarks
- LM Studio MLX 引擎(v0.3.4):https://lmstudio.ai/blog/lmstudio-v0.3.4
- mlx-lm(GitHub):https://github.com/ml-explore/mlx-lm
Calpa 擅長使用 TypeScript、React.js 和 Vue.js 建立 Responsive Website。
他積極參與開源社群,曾在 2019 年的香港開源大會上擔任講者,提供工作經驗和見解。此外,他也在GitHub 上公開分享個人部落格程式碼,GitHub 專案已累積超過 300 個 stars 與 60 個 forks。
他熱愛學習新技術,並樂意分享經驗。他相信,唯有不斷學習才能跟上快速演變的技術環境。
如果你有 AI 專案、網站開發或技術整合需求,或正在為團隊尋找工程師,歡迎來信交流:partner@calpa.me
歡迎訂閱 Calpa 的頻道,一同將想像力化為可能:相關文章
1.8 億行數學證明:當 AI 開始檢查 AI 寫的程式
AI 寫程式的成本已經趨近於零,真正的瓶頸變成了信任。同一週裡,Anthropic 生成 1.8 億行形式化證明、微軟用 AI Agent 完成 4 億行程式碼遷移。這篇文章聊聊形式化驗證這波浪潮、Lean 4 的數學賭局,以及為什麼我認為這是工程師的黃金時代。
每天提問,改寫人生劇本:ChatGPT 實踐阿德勒心理學的實戰指南
每天與 ChatGPT 對話、拆解行為動機,真的能改變命運嗎?本篇文章結合阿德勒心理學的「目的論」核心,分享我如何用每日提問重新設計人生選擇,打造屬於自己的改變流程,實現從困住到前進的轉變。
使用 AI 輔助開發 Go 語言專案:urusai 的誕生與研究型編程的樂趣
在Web3和AI技術快速發展的今天,作為一名專注於創新技術的系統架構師,我一直在尋找新的方式來構建更實用的工具。我最近發布的「urusai」項目正是這種探索的成果。這是一個使用Go語言開發的工具,用於生成隨機的網絡流量噪音,為用戶提供更好的網絡隱私保護。儘管我之前從未編寫過Go程式,但通過AI輔助編程,我成功地設計、開發並發布了這個專案。…
AI 寫的程式總是出錯?我用 TypeScript + 函數式設計讓它聽得懂!
你有遇過 AI 產生的程式碼完全跑不起來嗎?我曾經寫了一段計數器邏輯,結果它怎麼都看不懂。直到我用 TypeScript + 函數式設計重構,才發現——問題不在 AI,而是我們寫得不夠清楚。
我用 AI 研究 AI 會不會串通:28 場實驗、14 次邀請、全數拒絕
第一次投稿研究論文:三天的 AI Collusion Research Sprint,我用 AI Agents 當研究工具,研究 AI Agents 會不會秘密結盟。結果 14 次自願邀請全數被拒,但我學到更重要的事:拒絕、服從、偏袒,是三件必須分開量測的事。
🚀 三步搞定!用 AI 自動生成專屬求職信,快速提升錄取率
用 ChatGPT + Typst 快速生成履歷與求職信,搭配現代化模板與自動化流程,10 分鐘完成客製化申請文件,提升申請效率與錄取機率。