想像一下,凌晨兩點,你還在為黑客松整理贊助商資訊,一頁頁手動複製、點擊展開、整理格式,還要反覆對照更新版本……這樣的苦工讓人懷疑人生。
我曾經也陷入這種資料整理的深淵,直到我遇見 Firecrawl , 這款神級工具能自動爬整個網站、轉換成乾淨的 Markdown 或 JSON,一鍵搞定「餵資料給 GPT」或打造知識庫的所有步驟,省時又高效。
為什麼選 Firecrawl?相比傳統爬蟲的五大優勢

Firecrawl 把原本需要幾週才能完成的爬蟲設定,縮短為幾分鐘;遇到網站結構變動,它依然能穩定擷取資料。這對需要大量資料支撐 AI 應用的開發者來說,不只是「省事」,而是解鎖了新的資料流動方式。
| 🧩 項目 | 🔥 Firecrawl | 🐍 傳統爬蟲工具(BeautifulSoup4 / Scrapy) |
|---|---|---|
| ⚙️ 安裝與設置 | ☁️ 雲端 API,幾分鐘內即可啟用 | 🧱 本地安裝與環境設定,需撰寫大量邏輯 |
| 🕸️ 動態網站支援能力 | ✅ 支援 JavaScript 渲染、SPA、互動模擬 | ❌ BeautifulSoup 不支援;Scrapy 需搭配 Selenium,操作較複雜 |
| 🔌 擴充性與彈性 | 🧰 提供多語言 SDK,整合 Langchain、LlamaIndex 等 | ⚠️ 難以與 LLM 框架無縫整合,需自行設計格式轉換流程 |
| 🧵 並行效能與自動處理 | ⚡ 分散式架構處理,自動應對速率限制與代理輪換 | 🐢 Scrapy 雖支援並行,但需自行管理資源與調度 |
| 🔁 維護成本與穩定性 | 🤖 AI 驅動,能理解語義結構,自動適應變動網站 | 🔧 高度依賴 CSS selector 或 XPath,結構變動就要重寫 |
| 📊 適用場景與應用彈性 | 🧠 LLM 訓練資料、知識庫建構、競爭情報、內容監控等多樣化應用 | 🧾 適用靜態頁資料擷取,動態與交互型網站支援有限 |
與常見的爬蟲工具如 BeautifulSoup4 和 Scrapy 相比,Firecrawl 既保有簡單易用的 API,又具備強大彈性。BeautifulSoup4 雖容易上手,卻難以處理複雜或動態網頁;Scrapy 並行能力優異,但學習門檻較高。Firecrawl 則結合兩者優點,並透過雲端基礎設施與優化演算法,在性能上達到甚至超越傳統解決方案,同時高度自動化,省去手動配置與維護繁雜爬取邏輯的麻煩。
此外,Firecrawl 提供多語言 SDK(如 Python、Node.js、Go、Rust 等),方便整合至各種技術堆疊,並支援與 Langchain、Llama Index、Crew.ai 等 LLM 框架直接串接。其雲端服務架構可彈性擴展,無論是小型專案還是企業級應用,都能穩定處理大規模資料收集任務,開發者也能免於基礎設施維運的負擔,專注於業務創新。
Firecrawl 的基本概念與架構
Firecrawl 是一種 API 服務,其核心功能是接收 URL,爬取網站內容,並將其轉換為乾淨的 Markdown 或結構化數據格式。與傳統網頁爬蟲工具不同,Firecrawl 能夠爬取所有可訪問的子頁面,甚至不需要網站地圖 (sitemap) 就能高效率地完成工作。這種自動化的爬取能力使開發者無需手動配置複雜的爬蟲邏輯,大大簡化了數據採集過程。
Firecrawl 採用分散式架構設計,能夠並行處理多個網頁爬取任務,確保最快的結果輸出速度。其服務端包含了全面的日誌記錄系統,能夠追蹤操作狀態、性能指標、信用使用情況和速率限制等關鍵數據。這種設計不僅提高了系統的可靠性,也使開發者能夠更好地監控和管理其爬蟲操作。
這樣的架構讓 Firecrawl 在處理大型網站或動態頁面時,仍能保持穩定與高效。開發者不必再寫一堆繁瑣邏輯,就能快速取得乾淨可用的資料 , 真正做到「資料輸入一鍵自動化」。
Firecrawl 的核心技術強項在於其處理複雜網頁內容的能力。它能夠處理 JavaScript 渲染的動態內容、單頁應用 (SPA) 和其他通常難以爬取的網頁元素。這一能力源自其內置的智能等待機制,能夠確保頁面內容完全加載後再進行採集,大大提高了爬取的可靠性和效率。
資料擷取與轉換流程
Firecrawl 的工作流程設計得非常直觀,開發者只需提供目標 URL 和一些基本配置,系統就會自動完成複雜的爬取任務。這個過程主要包括以下幾個步驟:
首先,Firecrawl 接收目標 URL 並初始化爬取任務。它會自動處理代理輪換、反爬蟲機制、速率限制等複雜問題,確保爬取過程順利進行。這種自動化處理大大減輕了開發者的負擔,使他們無需關心爬蟲的底層實現細節。
其次,系統會分析網站結構,識別所有可訪問的子頁面,並進行智能爬取。這個過程中,Firecrawl 能夠處理各種複雜情況,包括需要點擊、滾動、輸入等交互操作才能訪問的內容。這種高級交互能力使 Firecrawl 能夠獲取傳統爬蟲難以觸及的數據。
最後,Firecrawl 將爬取的原始 HTML 內容轉換為乾淨的 Markdown 或結構化 JSON 數據,並返回給開發者。這種轉換過程經過精心設計,能夠保留原始內容的語義和結構,同時去除不必要的雜訊,為 LLM 應用提供高品質的輸入數據。
Firecrawl 功能全解:動態處理、互動模擬、格式轉換一次搞定
Firecrawl 是一款功能全面且強大的網頁爬蟲工具,具備靈活的網站爬取能力和豐富的設定選項。它不僅能夠高效地批量處理數千個 URL,還支援自訂爬取深度、請求頭、排除標籤等細緻控制,並能解析各種常見格式如 HTML、PDF、DOCX 等,滿足不同資料來源的需求。此外,Firecrawl 可根據場景需求輸出 Markdown、HTML、截圖或結構化 JSON 等多種格式,極大地提升了數據收集和應用的靈活性。
現代網站多以 JavaScript 動態渲染內容,傳統爬蟲往往難以應對。Firecrawl 針對這一挑戰,內建處理動態內容的能力,能夠正確擷取經 JS 載入的資料,同時支援自動化互動操作(如點擊、滾動、輸入、等待),使其能夠獲取需要用戶交互才能顯示的資訊,極大擴展了可擷取的網站範圍。
更進一步,Firecrawl 深度整合 LLM 應用,開發者可用自然語言或 schema 描述數據需求,Firecrawl 便能自動將非結構化網頁內容轉換為高品質的結構化數據。這種 AI 驅動的資料提取方式,既提升了開發效率,也簡化了從雜亂網頁到乾淨資料集的轉換流程,為 AI 應用和知識庫構建提供強大支援。
Firecrawl 的實際應用場景
想像一下,只要貼上一個產品頁的網址,你就能輕鬆取得全站的 FAQ、價格資訊、支援文件,還能自動整理成乾淨、好用的結構化資料。這讓原本繁瑣的蒐集流程變得像喝水一樣簡單。
Firecrawl 幫助各種開發者和團隊,無論你是要為 LLM 訓練打造高品質數據集,還是想快速建立 AI 聊天機器人的知識庫,都能大幅提升效率與靈活性。你只需要提出需求,Firecrawl 就會自動幫你爬取網站、轉換格式,產生結構統一、語義完整的 Markdown 或結構化數據。不論遇到多複雜的網站架構、JavaScript 動態載入,甚至多語言網頁內容,Firecrawl 都能輕鬆應對,讓資料收集變得無比順暢。
在企業知識管理、競爭情報、或市場研究領域,Firecrawl 也是不可或缺的好幫手。它可以自動化收集公司網站、產品文件、FAQ 內容,幫你快速建立內部知識庫;也能定期監控競爭對手網站、追蹤價格變化、抓取最新產品資訊,讓你隨時掌握市場動態。Firecrawl 的 AI 結構化數據提取功能,能夠從雜亂無章的網頁中萃取出最有價值的訊息,協助你精準做出決策。
更棒的是,Firecrawl 很適合自動化情報監控:像是新聞快訊、價格波動、網站內容異動等,只要設定好監控目標,系統就會自動追蹤,一有變化馬上通知你。這種全自動、彈性高、可靠的資料收集方式,不僅讓企業省下大量人力,也讓每個人都能輕鬆獲取最即時、最重要的網路資訊,為未來的創新和決策注入源源不絕的能量。
我的 Firecrawl 使用經驗:黑客松資料收集的高效實踐與心得
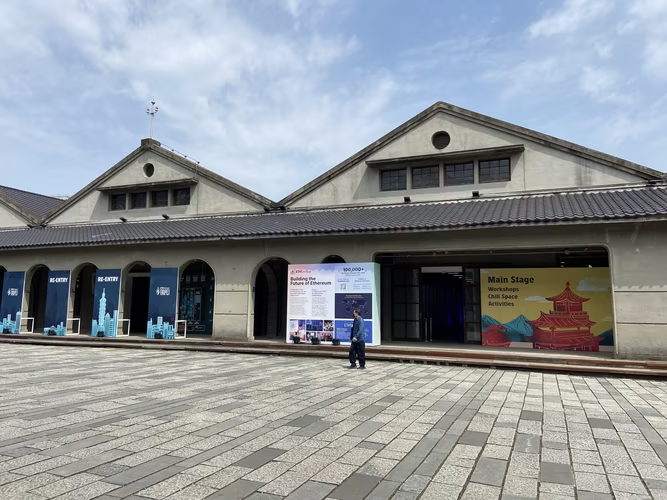
參加 ETHGlobal Taipei 黑客松的過程中,資訊收集的效率直接影響了團隊能否在短時間內聚焦正確方向、掌握關鍵機會。尤其是贊助商獎勵、技術要求、參考資源等資訊分散在官網多個頁面,傳統人工整理不僅耗時,還容易遺漏細節。這次,我選擇用 Firecrawl 來徹底革新備賽流程,讓資料收集和策略規劃都提速數倍。
⏳ 傳統收集法的痛點
ETHGlobal Taipei 的贊助商獎金頁面資訊龐雜,數十個單位、數百條規則,如果用人工 copy-paste 方式整理,往往要花上數小時,還要反覆對照更新。資訊一旦遺漏或有誤,可能直接影響團隊的賽道選擇與策略規劃。
🚀 Firecrawl 一鍵自動化備賽資料
Firecrawl 完美解決了這一痛點。只需輸入目標網址(如:https://ethglobal.com/events/taipei/prizes),Firecrawl 就能自動遞迴爬取所有子頁面,解析出贊助商名稱、獎金金額、技術棧、參賽條件與所有關聯連結,並自動生成結構化 Markdown 或 JSON。這意味著所有資訊一鍵到手,資料乾淨又完整。
🔗 步驟一:輸入網址啟動爬取
打開 Firecrawl Playground,將 ETHGlobal Taipei 獎金頁面網址貼上,點擊 Run。
📄 步驟二:取得結構化 Markdown 結果
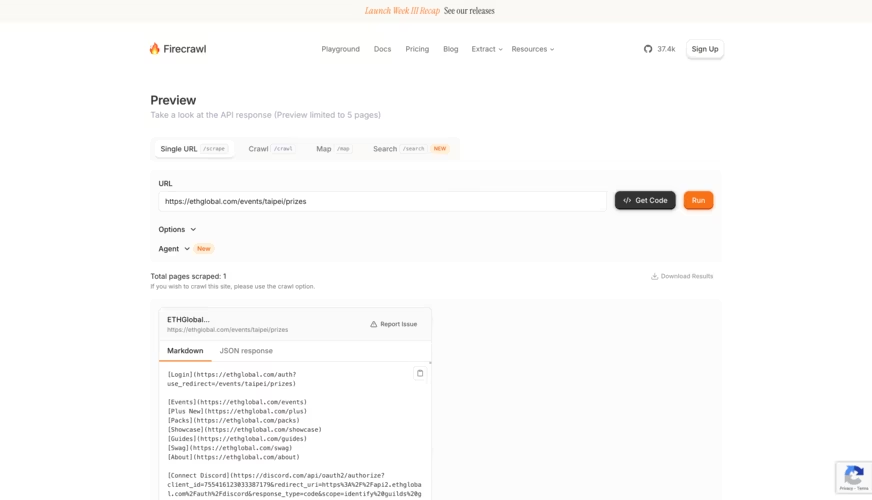
爬取完成後,系統會同時產出「Markdown」和「JSON」兩種格式。Markdown 結果條理分明,包含所有贊助商資訊、獎金條件、技術細節與參賽規則。你可以直接將這份 Markdown 複製到 ChatGPT 或任何 AI 工具,快速進行:
- 條列重點摘要與比較不同贊助商的技術要求
- 快速分析哪個賽道最適合自己的技術堆疊
- 生成專案提案、團隊分工和策略討論架構
- 直接規劃提案內容與 API 整合方向
🏆 得獎經驗分享:1inch 最佳資產儀表板銀獎

這次黑客松,我和團隊利用 Firecrawl 整理所有獎勵和技術細節,讓專案規劃更聚焦、更有策略。最終我們的 OrbitGO 多鏈資產儀表板專案,獲得 1inch 賽道「最佳資產儀表板」第二名銀獎,這份殊榮也是高效資訊整合與策略規劃的成果。
有了 Firecrawl,不僅大幅減少繁瑣的收集與整理時間,還能讓團隊快速聚焦於創意實現與技術突破,把有限的時間投入最有價值的事。
🎯 從資料收集到策略規劃,全面提速
現在,備賽流程從「資料打散、人工整理」升級為「自動化結構化輸出」。只需一鍵輸入網址,所有贊助商資訊、獎金細節、技術條件即刻到手,讓團隊能更快鎖定目標、快速構思技術方案,提升整體競爭力。
👉 立即體驗 Firecrawl Playground,讓資料自動化成為你黑客松致勝的關鍵武器!
Firecrawl 的技術整合與使用示例
Firecrawl 提供了多種編程語言的 SDK 和豐富的 API,使其能夠輕鬆整合到各種技術堆棧中。下面我們通過具體示例展示如何使用 Firecrawl。
Node.js 集成示例
在 Node.js 環境中使用 Firecrawl 非常簡單,只需幾行代碼即可實現網站爬取:
// npm install @mendable/firecrawl-js

import FirecrawlApp from "@mendable/firecrawl-js";

const app = new FirecrawlApp({ apiKey: "fc-YOUR_API_KEY" });

// 爬取網站
const scrapeResult = await app.scrapeUrl("firecrawl.dev");

// Firecrawl 會擷取整站資料,並以 markdown 格式回傳,
// 適合直接餵給 LLM 做 embedding 或索引。

console.log(scrapeResult.data.markdown);
這個簡單的例子展示了 Firecrawl 的基本用法,開發者只需提供目標 URL,就能獲取格式化好的 Markdown 內容。對於更複雜的需求,Firecrawl 還提供了豐富的配置選項,如指定輸出格式、設置爬取深度等。
Python 集成與結構化數據提取
Firecrawl 的 Python SDK 同樣易於使用,並支持高級功能如網站爬取和結構化數據提取:
from firecrawl import FirecrawlApp, ScrapeOptions

app = FirecrawlApp(api_key="fc-YOUR_API_KEY")

# 爬取網站
crawl_result = app.crawl_url(
    'https://firecrawl.dev',
    limit=10,
    scrape_options=ScrapeOptions(formats=['markdown', 'html']),
)

print(crawl_result)
對於結構化數據提取,Firecrawl 支持使用 Zod schema 或類似工具定義數據結構,然後自動從網頁中提取相應的信息。這種方法比傳統的基於選擇器的爬蟲更靈活,能夠更好地理解和提取語義信息。
與 LLM 框架的集成
Firecrawl 與各種 LLM 框架有良好的集成,例如 Langchain、Llama Index 等。這使得將爬取的數據用於 AI 應用變得非常簡單。例如,在 Langchain 中使用 Firecrawl 作為文檔加載器:
from langchain_community.document_loaders import FireCrawlLoader

loader = FireCrawlLoader(api_key="fc-YOUR_API_KEY", url="https://firecrawl.dev")
documents = loader.load()
這種無縫集成使開發者能夠輕鬆地將網頁數據轉化為 LLM 可用的文檔,大大簡化了 AI 應用的數據準備流程。
2025 年下旬重大更新:v2.5 與新定價
本文發佈於 2025 年 5 月,Firecrawl 在半年內有不少重要演進,這裡補充幾個關鍵變化:
Firecrawl v2.5(2025 年 10 月底發佈)主打「Semantic Index」語義索引與自訂瀏覽器能力,讓抓取結果更貼近 LLM 可直接使用的結構化資料;PDF Parser v2 改用 Rust 實作,解析速度提升約三倍,並新增 Auto Mode 自動選擇解析模式;Enhanced Mode(針對難爬網站的代理選項)在品質升級的同時也調整了計費方式,使用前建議先查看官方定價頁。
另外,定價體系已從原本的「點數制」過渡到「credits 制」,免費額度從 500 點翻倍到每月 1,000 credits,細節見下一節的價格說明。
Firecrawl 的價格模式與使用門檻
Firecrawl 採用靈活的價格模式,從免費計劃到企業級解決方案都有覆蓋,使其適用於不同規模和需求的用戶。
Firecrawl 在 2025 年下旬改為 credit 計費制:免費計劃每月提供 1,000 個 credits,適合初學者與小型項目;Hobby 計劃每月 5,000 credits,定價 19 美元(年付折抵後約 16 美元);標準與增長方案再往上疊加更高額度。具體價格以官方 Pricing 頁為準。
Firecrawl 的點數消耗根據不同的 API 請求而變化,例如基本的 scrape 操作消耗 1 點,使用 JSON 格式輸出消耗 5 點,使用 FIRE-1 代理進行提取則消耗更多點數。這種基於實際使用的計費模式使用戶能夠根據自己的需求選擇最合適的計劃。
對於企業用戶,Firecrawl 提供定制化的企業級方案,包括無限點數、自定義 RPM、批量折扣、優先支持等高級功能。這使得 Firecrawl 能夠滿足大型組織的複雜需求和高要求。
常見問題
-
Firecrawl 可以爬付費內容嗎? 目前主要支援公開可訪問的頁面,若有登入需求可透過自訂 headers 模擬 cookie。
-
Firecrawl 適合非工程師嗎? 若你不熟程式,建議使用 Firecrawl 提供的 API 搭配 LangChain Loader 模組,設定門檻較低。
-
有沒有試用方案? 有,免費計劃每月 1,000 credits,足夠測試上百頁網站,對小型專案或聊天機器人知識庫非常合適。
-
Firecrawl v2.5 有哪些新功能? 主要是 Semantic Index 語義索引、自訂瀏覽器能力,以及改用 Rust 的 PDF Parser v2(速度快約三倍、支援 Auto Mode)。Enhanced Mode 代理的品質與計費也有更新,抓取困難網站前建議先確認 credits 消耗。
-
Firecrawl 的定價跟以前不一樣了嗎? 是,已從「點數制」改為「credits 制」,免費額度從 500 點翻倍為每月 1,000 credits,付費方案以 credits 為單位。本文價格段落已更新至 2026 年 10 月的資訊。
結論
Firecrawl 代表了網頁爬蟲技術的新一代發展方向,憑藉 AI 增強的數據提取能力、全面的技術集成和靈活的價格模式,為開發者帶來強大且易用的網站數據採集工具。相比傳統方案,Firecrawl 大幅提升開發效率、降低維護成本,並提供更可靠的數據採集服務。在 AI 應用日益普及的今天,高品質數據成為關鍵,Firecrawl 能將網站內容轉換為 LLM 就緒的資料格式,為聊天機器人、專業 LLM 訓練、市場研究和競爭分析等場景提供高效、穩定的數據支持。隨著網站日益複雜、反爬蟲技術提升,Firecrawl 這類能自動處理複雜頁面、應對反爬蟲機制的工具愈顯重要,其開源性質和活躍社群亦保障了持續進化。總結來說,Firecrawl 為個人與企業提供了一個全面、高效且可靠的網頁數據採集解決方案,是 AI 時代理想的數據來源,助力 AI 應用加速開發與部署。
相關文章

1.8 億行數學證明:當 AI 開始檢查 AI 寫的程式
AI 寫程式的成本已經趨近於零,真正的瓶頸變成了信任。同一週裡,Anthropic 生成 1.8 億行形式化證明、微軟用 AI Agent 完成 4 億行程式碼遷移。這篇文章聊聊形式化驗證這波浪潮、Lean 4 的數學賭局,以及為什麼我認為這是工程師的黃金時代。
2025 前端技能圖譜:系統化學習之路—基於台灣招聘市場的研究與實踐
前端開發作為一個不斷演進的領域,每年都有新的技術和框架湧現。作為一名全棧開發者,我長期以來一直在思考如何系統化地組織前端知識,並將這些知識有效地傳遞給更多人。這篇文章將分享我如何基於台灣招聘市場的研究,構建了一套全面的前端技能圖譜,以及我未來的寫作計劃。
關於 2018 年的 Calpa Liu
你好,歡迎來到我的博客。我是 Calpa,一個喜歡寫技術文章的前端程序員。
每天提問,改寫人生劇本:ChatGPT 實踐阿德勒心理學的實戰指南
每天與 ChatGPT 對話、拆解行為動機,真的能改變命運嗎?本篇文章結合阿德勒心理學的「目的論」核心,分享我如何用每日提問重新設計人生選擇,打造屬於自己的改變流程,實現從困住到前進的轉變。
在瀏覽器裡逛教堂:用 A-Frame 打造三座 360° 聖殿
這個小專案把三座教堂的 360° 全景照片變成一個可以在瀏覽器裡自由切換的 WebXR 體驗。從內容到技術棧,再到工程化部署,本文記錄我如何用 A-Frame、Vite 和 Cloudflare Pages,做出一個既簡單又有臨場感的 360 教堂圖庫。
使用 AI 輔助開發 Go 語言專案:urusai 的誕生與研究型編程的樂趣
在Web3和AI技術快速發展的今天,作為一名專注於創新技術的系統架構師,我一直在尋找新的方式來構建更實用的工具。我最近發布的「urusai」項目正是這種探索的成果。這是一個使用Go語言開發的工具,用於生成隨機的網絡流量噪音,為用戶提供更好的網絡隱私保護。儘管我之前從未編寫過Go程式,但通過AI輔助編程,我成功地設計、開發並發布了這個專案。…