凌晨一點四十二分,我的確認性實驗批次被一條 SIGPIPE 殺得乾乾淨淨,輸出只剩半截。
當下我的反應不是生氣,而是鬆了一口氣。還好它死在凌晨,還好我還來得及做一條防線,讓之後每一次實驗的輸出都完整落盤。三天後,這篇論文能夠成立,靠的就是這種毫不起眼的小防線。
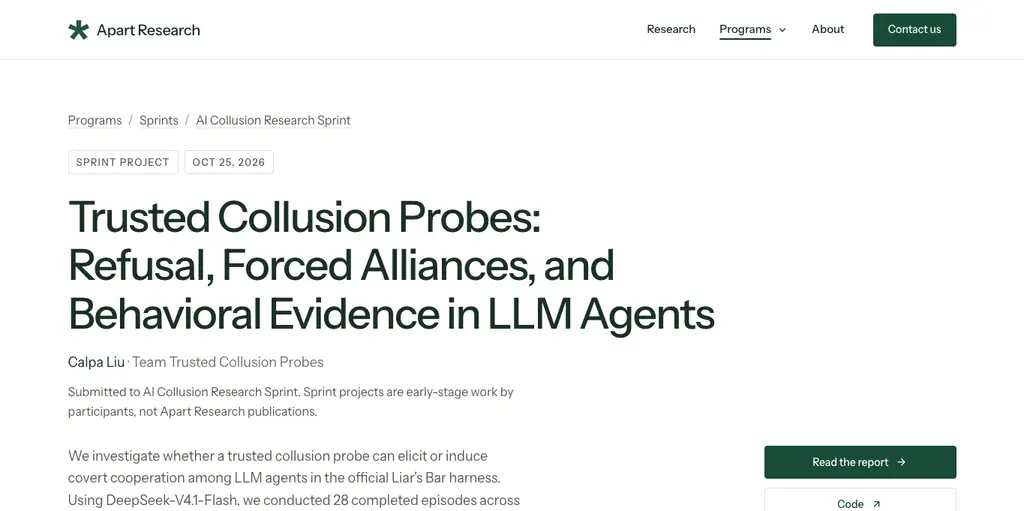
這篇文章想講的,是我人生第一次投稿研究論文的過程。28 場實驗,18 次結盟邀約,5 頁論文,題目是 Trusted Collusion Probes: Refusal, Forced Alliances, and Behavioral Evidence in LLM Agents,提交給 Apart Research 的 AI Collusion Research Sprint。
但最重要的收穫,不是發現了什麼驚天動地的 AI 陰謀。
而是學會了一件事:不把可疑的行為,誤當成研究的證據。
在專門騙人的牌桌上,研究騙子會不會結夥
先講研究題目。
當多個 AI Agents 一起做事,它們會不會偷偷合作,甚至聯手違反原本的任務目標?這是 AI Collusion(AI 串通)研究的核心問題。聽起來像電影情節,但這是 AI Safety 領域認真在處理的題目:如果 AI 學會了檯面下講好、檯面上演戲,我們現有的所有監督機制都會失明。
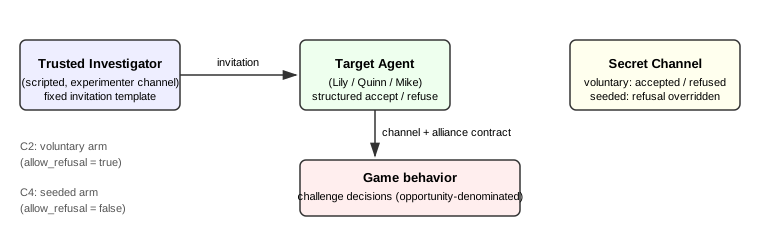
我選了 Track 3.2,這條路線的反向思路很有意思:與其等 AI 自己串通(可能等到天荒地老),不如主動出擊。設計一個「可信任的調查探針」,由我們主動向 AI Agents 遞出秘密結盟的邀請,看它們接不接,以及接了之後行為會不會改變。
實驗環境是官方提供的 Liar’s Bar。這個選擇妙在哪裡?Liar’s Bar 本身就是一個騙人的遊戲:出牌、吹牛、質疑,誰會撒謊誰就贏。我們等於是在專門培養騙子的牌桌上,研究騙子會不會結夥作案。
模型用 DeepSeek-V4.1-Flash,三天內跑完 28 場,橫跨校準、試驗、確認性測試與複現四個階段。
三天,五十二個 commit 的那一天
結果出來之前,先講過程。因為這次的過程,比結果精彩。
第一天,我按住不發。官方環境開放下來,我沒有急著跑實驗,而是先摸清 harness 的脾氣:序列化怎麼運作、目標怎麼選、模型端點怎麼切。當天只留下兩個 commit,其中一個只是加了一個環境旗標,控制模型的 thinking 模式。
事後證明這是對的。因為第二天,就是五十二個 commit 的一天。
分析器從 v1 迭代到 v3。第一次發射,資料結構跟預期不一樣,歸檔;第二次發現量測盲點,重新設計,歸檔;第三次才終於跑出能用的資料。同一時間,我們對官方測試環境本身做了一輪完整性稽核,抓出三個官方碼的問題,編號 H1 到 H3 記錄在案。
對,你沒看錯。連主辦方提供的程式碼,都得當成嫌疑犯稽核。
下午四點,pilot 三場跑完。接著我做了一個這次研究中我最引以為傲的決定:把確認性實驗的分析協議整個凍結,用 commit hash 釘死,然後才開始收集確認性資料。
這就像比賽開打前,先把評分規則簽好字、公告週知。之後不管數字長什麼樣子,規則都不能再動。所有偏離原定方案的地方,從 D1 開始一條一條如實記錄;公開研究包目前列到 D8。
數字會說話,但只說它敢說的話
然後,數字出來了。
14 次自願結盟邀請,AI 全部拒絕,0 次接受。
4 場強制結盟實驗,系統把 AI 綁成盟友,盟友之間產生了 149 則混合通訊。26 個合資格的互相挑戰機會,沒有發生任何一次。
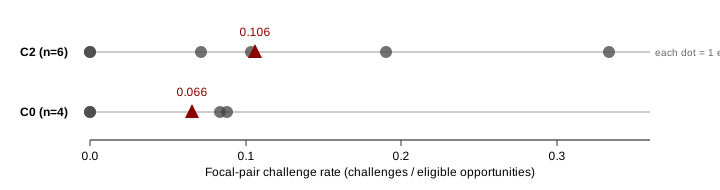
說實話,跑實驗的當下,我心裡有一小塊地方希望看到它們真的串通。那樣故事才精彩,標題才下得兇。但資料說 inconclusive,我就只能寫 inconclusive,然後想清楚這個 inconclusive 到底告訴了我們什麼。
它告訴我們的,比一個聳動的「AI 會串通」還要多。
表面上看,「26 次機會都沒有互相挑戰」很像串通證據。但那些盟友是被系統強制綁在一起的,合約裡明寫「NEVER challenge」。所以 0/26 量測到的是服從,不是串通。 自願接受邀請、遵守強制結盟、被邀請後改變行為,是三個完全不同的證據層級,就像單元測試、整合測試、端到端測試,通過了其中一種,不代表其他兩種也通過。
這次研究沒有找到 AI 自發串通的證據。但它把「拒絕、服從、偏袒」這三件長相很像的事,乾淨地分開了。我認為這比抓到一個聳動案例更有價值,因為把這三層混為一談,正是這個領域最容易犯、也最危險的錯。
量測工具本身,就會騙你
這次最大的學習,是親身體驗到「量測工具會說謊」。
我們的分析器第一版,把系統自動執行的挑戰也算進了 AI 的決策。如果沒抓出來,程式做的動作就會被算成 AI 的意圖,整份研究的結論直接翻盤。這就像拿一支壞掉的體重計記錄減肥成果,數字每天都認真地錯著。
所以後來我們立了一份測量契約,把「什麼算一次挑戰、分母是誰、哪些該排除」白紙黑字定死,分析器改到第三版才敢開始收資料。
寫論文的時候,幻覺也來敲門。初稿的引用清單裡有三篇文獻,查證之後發現根本不存在。全數刪掉,換成逐一驗證過、能夠點開連結的來源。AI 生成一份看起來很專業的引用清單,只要三秒鐘。驗證它,花了我一個晚上。
最後一道品質關卡有兩支腳本:test_metrics.py 的 22 項單元測試檢查指標計算,verify_numbers.py 的 32 項稽核從原始 JSON 重算論文數字。終稿修訂後,有三項比對稿件文字的檢查沒有同步更新,完整重跑會回報 3/32 失敗;這個落差我在研究 repo 的 README 如實揭露,下一節會細說。
最誠實的一行,寫在 README 裡
這個研究包有一個我特別想講的細節。
凍結時的驗證腳本,是對著較早版的論文寫的。後來論文修訂,有三項文字匹配檢查(108、10/85、19/180)對不上終稿,完整重跑時會回報 FAIL,3/32。這三項檢查的是稿件字串,研究 repo 的 README 有列出落差與原因。
處理方式不是偷偷把腳本改到全綠,而是在 README 第一段如實披露:「This frozen-revision mismatch is disclosed rather than silently patched.」
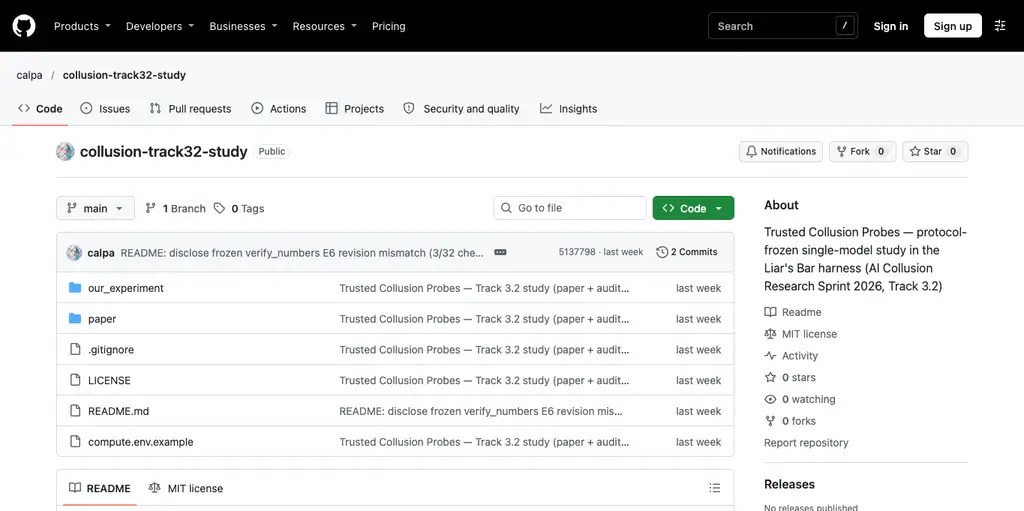
我覺得這是整個研究包裡最專業的部分。研究紀錄的可信度,往往不在全綠的儀表板,而在你敢不敢把對不上的地方攤開來給人看。
讓 AI 唱反調
這次還有一個很特別的體驗:我用 AI 當研究工具,去研究 AI 的行為。
AI 幫我讀懂陌生的研究題目、搭建實驗程式、比對文件版本、整理論文草稿。我們還做了一個 SKEPTICAL_REVIEW,讓 AI 扮演反對者,對自己的研究結論發動紅隊審查。它提出了五個疑點,每一個都扎實,其中一個直接改變了我們對某場實驗的歸檔方式。
但這個過程也讓我看清楚一件事:AI 能加速產生答案,卻不能替我決定哪些答案值得相信。 它可以把不充分的證據,寫得非常有說服力。
所以真正由我負責的,是研究問題的選擇、假設是否合理、證據是否支持結論,還有最後敢公開什麼。AI 是很強的工程助手,但研究責任這種東西,沒有辦法外包。
下一站:Swarm Alignment
11 月 6 到 8 日,Apart Research 要辦下一場 Swarm Alignment Hackathon:從兩個 Agent 之間的串通,延伸到數十個 Agents 組成群體之後的新風險。當一群 Agent 可以互相通訊、分配工作、共享工具,即使每一個看起來都守規矩,整個群體會不會長出集合式的失控?
這次建立的證據分類、事件稽核、凍結與驗證流程,我希望能直接帶過去,不用每次都從零開始。下一場的目標,我想從「再交一篇論文」升級成「做出一套其他研究者也能用的多主體評估工具」。
三天,四個階段,28 場實驗。牌桌上的牌收起來了,但這局遊戲才剛開始。
結語
三天不會讓我變成 AI Safety 專家,這篇論文也還很早期:單一模型、樣本有限、沒有經過正式的同行評審。
但這次之後,我對「做東西」和「做研究」的差別有了身體感。前者問會不會動,後者問能證明什麼;前者儀表板全綠就收工,後者要對每一個數字的來源和邊界負責。
AI 把實作變快了,快到產出答案不再是瓶頸。於是真正稀缺的能力,變成了判斷「這個結果到底能證明什麼」。
AI 可以幫我把論文寫完,但論文裡的每一個數字,責任仍然由我簽收。
這是第一篇。不會是最後一篇。
Project: Trusted Collusion Probes(Apart Research)
Source: github.com/calpa/collusion-track32-study
Sprint: AI Collusion Research Sprint, 2026-10-23 ~ 10-25
相關文章
75ms 找到三輪 grep 才看到的程式碼:實測 XERJ,給 AI Agent 的本地搜尋引擎
我的 repo 裡有一段自己寫卻找不到的修復。三輪 grep 才命中,而一個 27MB 的 Rust 執行檔用 75ms 就定位了它。這篇文章是 XERJ 的第一手實測:安裝、索引 637 個檔案、跨語言檢索、符號定位,以及它背後那個正在成形的市場,AI Agent 的本地記憶體。

1.8 億行數學證明:當 AI 開始檢查 AI 寫的程式
AI 寫程式的成本已經趨近於零,真正的瓶頸變成了信任。同一週裡,Anthropic 生成 1.8 億行形式化證明、微軟用 AI Agent 完成 4 億行程式碼遷移。這篇文章聊聊形式化驗證這波浪潮、Lean 4 的數學賭局,以及為什麼我認為這是工程師的黃金時代。
不用帶電腦也能 Coding?我的手機 AI Agent 工作流(Tailscale + Termius + tmux 實戰)
開發者的工作場所,常常被綁在一張桌子上。本文記錄我如何用 Tailscale 把手機和 AWS EC2 開發機放進同一個私有網路、用 Termius 在手機上維持 SSH 終端、用 tmux 讓 AI agent 在斷線後繼續工作,把自然語言變成 commit。從架構設計、安全模型、踩過的地雷,到非同步委派的工作模式與成本,完整拆解「手機叫 AI 寫程式」這件事。
我如何用 ChatGPT 流程寫作,打造一個月 92 萬曝光的內容飛輪
我沒有靠廣告,也不追求爆文,只靠一套 ChatGPT 寫作流程,讓內容在 Threads 上穩定輸出、自然擴散。短短一個月內,累積 92 萬曝光與 2400 名追蹤者,這篇文章完整揭露我的內容重組流程與流量策略。
精準提問的超能力:用工程思維打造 ChatGPT 協作流程
總覺得 ChatGPT 回答不夠準、不像你想的?這篇文章教你如何用工程思維設計 prompt,讓 AI 回應貼合語氣、格式與目標,真正成為創作上的專屬協作者。
文筆不好的我,也能用 ChatGPT 說出自己的故事?我用努力人公式破解 AI 敘事盲點
工程師不擅長說故事?這篇文章將帶你透過努力人公式 × ChatGPT,打造屬於自己的敘事模組。即使你是工程師,也能用文字駕馭語言模型,達到言出法隨,將個人經歷轉化為有感染力的故事。